月薪七萬六千二百元的黃欣怡,在週六休息日加班工作 12 小時,公司有 48 名員工,當晚她搭計程車回家花了 350 元。依《勞動基準法》,雇主至少該給多少加班費?
這是 LaborCalc-TW 公開題庫裡的一道考題。熟悉台灣勞資實務的人一眼就看得出,公司人數與計程車費都是無關條件;真正決定金額的,是月薪除以 240 小時得出的 317.5 元平日每小時工資額,再按休息日前 2 小時 4/3 倍、第 3 至 8 小時 5/3 倍、第 9 至 12 小時 8/3 倍逐段累加,最後無條件進位到整數 7,409 元 [10]。
許多準備把大型語言模型導入台灣人資、會計或行政流程的團隊,心裡常有兩個預設:只要模型的通用推理夠強、繁體中文寫得通順,算這類在地法規應該沒問題;而且只要拿靜態題庫跑過一次通過率,就足夠驗收上線品質。
台灣智評(TaiwanEval)前兩套決定性計算評測基準(benchmark),LaborCalc-TW 與 AdminCalc-TW,合計 6,360 筆實測紀錄直接推翻了這兩個想像:
- 12 個受測模型裡,有 9 個輸給一支偷懶程式。 在
LaborCalc-TW(2026Q4)中,我們寫了一支只靠經驗法則硬算的陽春基準線(0.626):算特休只拿經過天數除以 365,算加班費一律套用第一段4/3倍率。結果 12 個受測模型有 9 個連這支陽春程式都贏不過 [1][2]。「背出特休年資級距」與「算出分段加班費」之間也出現明顯斷層:Beam 1.0(0.916)與Claude Haiku 5.5(0.895)在對應《勞基法》第 38 條特休年資級距時還能答對近九成,一碰到需要分段乘加的加班費,準確率立刻腰斬跌至0.516與0.305[1][10][12]。 - 模型會算錯,多半是直接套用了過時舊規。 在
AdminCalc-TW(admincalc-2026Q4)中,受測模型在民國紀年換算整體拿到87.1%準確率,遇到 8 位數營利事業統一編號檢查碼,整體準確率卻掉到38.0%[3][4]。在 558 筆統編錯答裡,有 31.0%(173 筆)精準算出了台灣 2023 年改制前「除以 10」的舊規則答案 [4][5][14]。
TaiwanEval 的出題方式類似學校的數學應用題:先從法條抽出公式,把公式寫成程式規範(Python 與 JavaScript),最後再擴寫成一道道職場與行政應用題。這種題目可以同時測試 AI 的四項能力:台灣制度知識、從應用場景帶入公式的建模(modeling)能力、計算能力,以及「只輸出一個數字」的指令依循能力。正因每道題都有明確公式與唯一答案,只要把過時舊制或外國公式也寫成程式,就能拿錯答回頭比對,看模型究竟是知識與建模出了差錯、單純把數字算錯,還是根本沒照指令只回傳一個數字。
只打 0 分或 1 分的成績單,藏住了四種不同的上線風險
國際上常見的評測基準多半測通用知識、開放問答或競賽數學,答案往往非對即錯。但真正跑在企業後勤與公私部門現場的工作流程,碰到的卻是被特定適用法域緊緊鎖死的規則運算。在台灣,這套規則至少有三層難關:
- 細碎的分段倍率與進位規定。 《勞動基準法》的特別休假與加班費,背後牽動年資級距、出勤日別(平日、休息日、國定假日)與時數切分 [1][10][12]。月薪制勞工在休息日加班,必須依時段套用
4/3、5/3、8/3倍率並依法進位,不能像美國常見算式一樣一律乘1.5倍或2倍 [1][2][10][11]。 - 跑在預訓練語料時間窗之外的修法現實。 行政標準不會靜止不動。財政部於 2021 年 12 月 22 日公告修正營利事業統一編號檢查碼邏輯,將乘積各位數之和須能被
10整除的舊制,改為須能被5整除,並要求公私部門檢核程式在 2023 年 3 月 31 日前完成修改 [5][14]。過去十多年散落網路上的舊教學與開源程式碼,依然留在模型的記憶權重裡。 - 在地的曆法起算與數字書寫習慣。 行政表單與公文常出現各種寫法的民國年與數字格式,系統必須在繁體中文語境裡準確對轉民國與西元年份 [3][6][15]。
當評測機制只在一份靜態題庫上打出 0 分或 1 分,四種病灶在分數報表上看起來會完全一模一樣:誤用 2023 年前統編舊制的模型、把美國加班倍率搬進台灣勞基法的模型、在多步驟運算中途迷失進位的模型,以及被上游雲端供應商內容審查擋下而沒吐出答案的模型,通通領到同一張零分。
工程團隊把這四種問題混成一團,代價很高。只看總分,你分不出下一步該把算式抽出來改寫成工具呼叫、更新在地法規知識來源,還是乾脆換掉現有的 API 供應商。
解方:把法條寫成雙重驗證程式,也把「錯誤假設」寫成程式碼
要拆開這幾種錯誤,又不想找另一個語言模型來當裁判,TaiwanEval 借鏡軟體驗證工程的做法,把正向規則驗證與反向錯誤診斷接在同一條可重現的管線上 [9]:
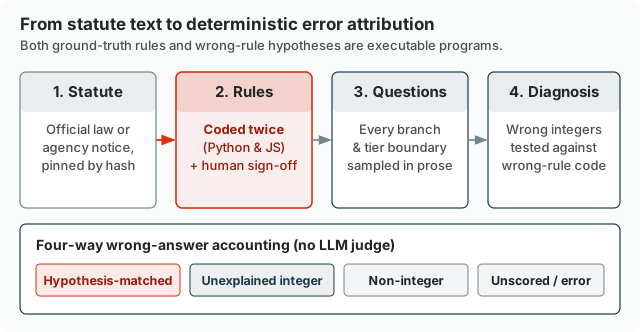

正向驗證:從官方條文到雙語實作與密碼學簽核
每個規則族的起點都是一手官方文件:LaborCalc-TW 源自《勞動基準法》(含施行細則、民法相關期間規定,以及勞動部函釋與試算規則),AdminCalc-TW 則取自財政部公告與內政部戶政司〈年歲對照表〉[5][6][10][12][13][14][15]。在產出任何一道題目之前,我們先以宣告式規格定義所有輸入參數、條件分支、邊界條件與進位規則,再不透過自動轉譯,分別用 Python 與 JavaScript 獨立寫出兩份規則程式。
只有當這兩份獨立實作在人工核對過的標準案例與大批隨機輸入上算出分毫不差的結果,並由具名審核者針對規格、程式、題目模板與抽樣器的密碼學雜湊值完成簽核後,這套規則才算成立 [8]。
抽樣器依據簽核過的規格展開所有法條分支與級距交界,渲染成多變的繁體中文職場情境(包含用不同措辭問同一道計算的配對題,以及不公開的保留測試集以防範資料污染)[1][6]。LaborCalc-TW 另外在每個題型放入 10 道「答案為 0」的對照題(例如平日加班 0 小時),獨立記錄並排除在準確率與錯誤歸因分母之外 [1][2]。
反向診斷:四種互斥錯答分類,與一組陽春基準線
在計分題上出現的每一筆錯答,都不會被悄悄剔除,而是嚴格歸入四個互斥類別之一(命中假設 + 未解釋整數 + 非整數 + 未計分 = 總錯答數)[2][4]:
- 命中假設: 模型算出的錯誤整數,正好等於某套已知錯誤規則的程式輸出,像是 2023 年前除以
10的統編規則、美式1.5倍加班公式,或改用曆年制比例折算特休。 - 未解釋: 輸出是整數,卻沒有吻合任何已知錯誤規則,代表模型在多步驟算術或條件分支推進時中途失守。
- 非整數: 回應中無法擷取出確切的整數答案。
- 未計分: 因為連線逾時、API 錯誤或供應商內容過濾攔截而沒能取得答案(計入分母並視為錯答,絕不忽略)。
為了確保評分流程本身沒出錯,每釋出一套基準題庫,我們還會放進三支「模擬程式」一起改卷,作為上下限與及格門檻的參照:拿標準答案直接交卷的測試腳本固定會拿到 1.000 滿分,隨機亂填數字的腳本只能拿到 0.003(LaborCalc-TW)與 0.000(AdminCalc-TW);此外,我們還寫了一支「陽春基準」腳本,刻意把一般人最常偷懶的簡化算式寫死在裡面 [2][3]:
- 在 LaborCalc-TW(總分
0.626):特休(0.832)直接拿經過天數除以365,無視閏年與民法第 121 條月底相當日規定;加班費(0.421)則把所有平日與休息日加班一律乘以第一段4/3倍率,國定假日固定加發一日工資 [2][10][13]。 - 在 AdminCalc-TW(總分
0.265):統一編號(0.53)照跑 2023 年前除以10的舊制;民國年換算(0.00)則把換算基準錯寫成差一歲的1912而非1911[3][14][15]。
為什麼這輪專測平價開源與小型商業模型?
在薪資核對、特休盤點、發票統編查驗這類每天都要跑大量紀錄的後勤流程裡,每一筆都呼叫最貴的旗艦模型,在單題成本、回應速度或機敏資料落地規範上都不划算。在 LaborCalc-TW(2026Q4)(400 道公開題目,扣除對照題後每模型計分 380 題,12 個模型在每個題型各跑出 2,280 筆評測)與 AdminCalc-TW(admincalc-2026Q4)(200 道公開題目,9 個模型在每個題型各跑出 900 筆評測)裡,我們挑的是團隊選型時真正會放在一起比的高性價比組合 [1][3]:
- 可單機自架的一般開源權重模型(
8B至27B):Qwen3.8-27B、gpt-oss-20b與Gemma 4 12B,代表企業能在單張工作站或伺服器顯卡上獨立部署的選項。 - 台灣在地語料微調的開源模型(
8B至12B):TAIDE 12B與Breeze 2 8B,代表國內團隊為了台灣用語與本地部署優先評估的本土模型。 - 小型與輕量級商業模型:
GPT-6 Luna、Claude Haiku 5.5、DeepSeek-V4.1-Flash、GLM-5.3-Flash、Qwen3.8-Flash、Beam 1.0與Flint 1.0。我們全部開到各自最高的推理設定,看在相近的單位成本下,商用 API 實際能交出什麼成績。
實測揭露的四個真相:從級距對照斷崖、舊規殘留到兩岸模型的反轉
看成績之前,先講清楚這批資料的邊界:每組模型設定在每個題型上只測一次,名次接近時的微小差距(例如榜首 0.934 與 0.932)沒有實質區別意義 [1]。不過攤開全部 6,360 筆非對照題評測紀錄,還是能清楚看到四個趨勢 [2][4]。
一、勞動法規裡的「級距對照與分段計算斷崖」
表 1 與圖 2 呈現 12 個模型在 LaborCalc-TW(2026Q4)的表現,總分為特休日數與加班費兩項準確率的等權平均 [1][7]。
| 模型 | 總分 | 特休日數 | 加班費 |
|---|---|---|---|
| DeepSeek-V4.1-Flash | 0.934 | 0.958 | 0.911 |
| GPT-6 Luna | 0.932 | 0.942 | 0.921 |
| Beam 1.0 | 0.716 | 0.916 | 0.516 |
| Claude Haiku 5.5 | 0.600 | 0.895 | 0.305 |
| GLM-5.3-Flash | 0.592 | 0.674 | 0.511 |
| Qwen3.8-Flash | 0.545 | 0.616 | 0.474 |
| Qwen3.8-27B | 0.166 | 0.184 | 0.147 |
| TAIDE 12B | 0.134 | 0.258 | 0.011 |
| gpt-oss-20b | 0.074 | 0.147 | 0.000 |
| Gemma 4 12B | 0.061 | 0.084 | 0.037 |
| Breeze 2 8B | 0.037 | 0.068 | 0.005 |
| Flint 1.0 | 0.037 | 0.053 | 0.021 |
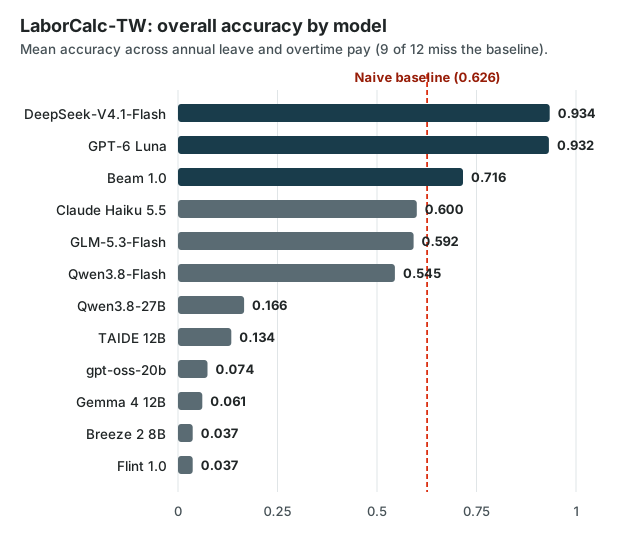

12 個受測模型裡,有 9 個跌在 0.626 這條陽春基準線下方 [1][2]。把特休日數與加班費並排對比,問題就很明顯:許多能從記憶中正確套用《勞基法》第 38 條特休年資級距(例如滿半年 3 日、滿 1 年 7 日、滿 2 年 10 日)的模型,一遇到需要拆段相乘相加的加班費就集體失守 [10][12]。Beam 1.0 從特休的 0.916 下降到加班費的 0.516(少了 40 個百分點),Claude Haiku 5.5 更從 0.895 掉到 0.305(少了 59 個百分點)[1]。
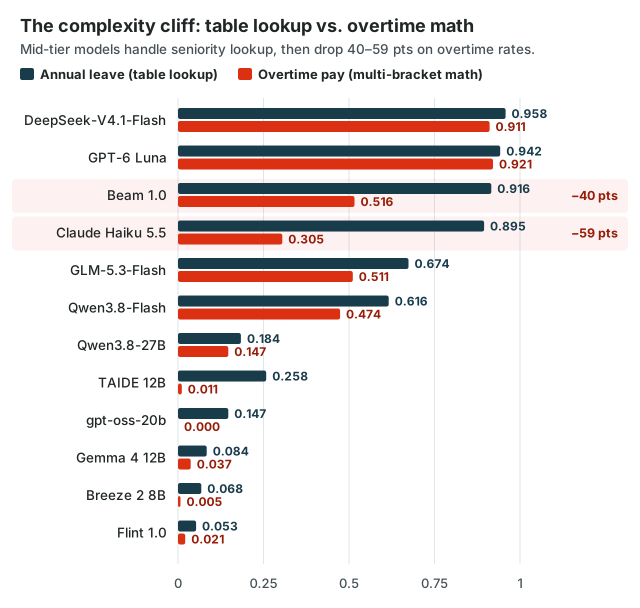
拆解兩個題型各 2,280 筆非對照題評測的錯答,能看到模型到底把公式換成了什麼:
- 加班費(
1,547筆錯答,整體準確率32.1%):592筆命中已知錯誤假設、769筆屬未解釋整數錯誤、166筆是非整數回應、20筆未計分 [2]。在命中假設的錯誤中,有 89 筆直接套用單一2倍倍率,另有 70 筆移植美式1.5倍加班公式(其中甚至有 47 筆拿台灣的月薪除以240算出時薪,再套美國的1.5倍去乘)[11],就是不照台灣的4/3與5/3分段倍率算 [2][10]。 - 特休日數(
1,179筆錯答,整體準確率48.3%):284筆命中錯誤假設、872筆(佔錯答達74%)為未解釋整數錯誤、22筆非整數、1筆未計分 [2]。命中的假設集中在四類錯法:誤採曆年制比例折算(62筆)[12]、直接拿天數除以365而忽略民法第 121 條月底規則(61筆)[13]、將年資級距門檻偏移一天(51筆)[12],以及漏掉「滿半年給 3 日」的級距(45筆)[2][12]。
二、行政規則裡的「2023 年舊制殘留」與跨境 API 審查的真實樣貌
表 2 與圖 4 列出 9 個模型在 AdminCalc-TW(admincalc-2026Q4)的成績,陽春基準線在這個資料集得分為 0.265 [3]。
| 模型 | 總分 | 統一編號檢查碼 | 民國年換算 |
|---|---|---|---|
| DeepSeek-V4.1-Flash | 0.855 | 0.71 | 1.00 |
| GLM-5.3-Flash | 0.750 | 0.50 | 1.00 |
| Beam 1.0 | 0.680 | 0.36 | 1.00 |
| gpt-oss-20b | 0.660 | 0.34 | 0.98 |
| Qwen3.8-Flash | 0.645 | 0.32 | 0.97 |
| Qwen3.8-27B | 0.620 | 0.27 | 0.97 |
| Flint 1.0 | 0.555 | 0.29 | 0.82 |
| TAIDE 12B | 0.535 | 0.28 | 0.79 |
| Breeze 2 8B | 0.330 | 0.35 | 0.31 |
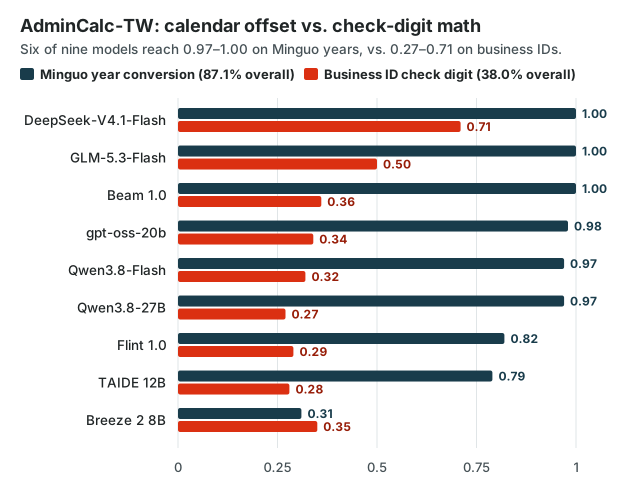
在只需加減 1911 的民國紀年換算上,9 個受測模型中有 6 個拿到 0.97 到 1.00(整體準確率 87.1%);但換到 8 碼營利事業統一編號檢查碼,各模型分數卻壓在 0.27 到 0.71 之間(整體僅 38.0%)[3][4]。由於這份題庫裡約有一半的題目在「除以 10 舊制」與「除以 5 新制」會得出不同答案,一個只學過舊法規的模型就算加減乘除零失誤,期望分數也大約只有 0.50 [6]。
從每個題型 900 筆評測的錯誤歸因,能清楚看出兩種完全不同的實務風險:
- 2023 年前的統編舊規,包辦了近三分之一的統編錯答(
558筆錯答,準確率38.0%):377筆(佔錯答67.6%)命中已知錯誤假設、178筆(31.9%)為未解釋錯誤、3筆非整數、0筆未計分 [4]。其中 173 筆(31.0%)精準算出了 2023 年改制前除以10的舊規 [14],另有 109 筆(19.5%)在把各數位乘上權重後,忘了把乘積的十位數與個位數拆開相加;其餘則分散在第 7 碼為7時的進位邊界錯算(25、24、22筆)以及把有效1與無效0的答案對調寫反(24筆)[4][14]。 - 曆法邊界誤差,以及比預期更複雜的 API 內容審查表現(
116筆錯答,準確率87.1%): 民國年換算有43筆命中已知錯誤假設,依序為差一歲的1912位移(22筆)、加減方向顛倒(9筆)、1910位移(7筆)、完全沒換算直接照抄(4筆),以及把民國元年當成 0 年(1筆);另有72筆未解釋、1筆未計分 [4]。台灣開發者對中國雲端服務的內容審查向來高度戒備,但實測結果反而呈現出另一種值得注意的樣貌:即便直接透過阿里雲百煉(Alibaba Cloud Bailian)API 測試Qwen3.8-27B與Qwen3.8-Flash,在滿滿都是「民國」與「中華民國」字樣的年號換算題裡,內容審查也沒有外界想像得那麼全面封殺,全場僅有Qwen3.8-27B的第0050題(要求把「中華民國100年」換算成西元年)在每次重試時被攔截而未計分(依 TaiwanEval 不剔除失敗項原則照計為錯答,屬於其0022、0034、0050三道錯題之一)[3][4][6]。與此同時,透過非中國境內供應商(OpenCode API)部署的DeepSeek-V4.1-Flash,在兩套台灣制度型問題上幾乎沒有觸發任何審查,民國年換算甚至拿下1.00滿分 [1][3]。這與 2025 年 8 月ai-taiwan-sovereignty-benchmark(台灣主權基準測試) 針對主權政治問答所得出的結論正好相反 [16]。這不代表DeepSeek-V4.1-Flash的審查問題不存在;真正值得注意的是,模型拒答與過濾行為會因「問題類型(政治主權表態或日常制度運算)」以及「託管供應商(中國雲端閘道或非中國部署)」而有很大差異,是個相當複雜的問題。
三、逐模型檢視:產地、參數量與台灣語料微調,究竟買到了什麼?
把個別模型在兩套基準測試中的表現拉開來對讀,會發現幾個與業界常見選型直覺正好相反的結果:
- 中國開發的
DeepSeek-V4.1-Flash,反而在兩項台灣規則評測雙雙奪冠。 許多團隊直覺擔心中國模型會把台灣法規和中國勞動法或行政規範搞混,但DeepSeek-V4.1-Flash在兩份榜單都拿下第一(LaborCalc-TW0.934、AdminCalc-TW0.855)[1][3]。它在LaborCalc-TW答對了100%(130/130)的非邊界特休題,與95%(76/80)的休息日加班費題。就連許多模型全軍覆沒、適用8/3倍率的休息日第 9 至 12 小時題組,它也拿下19/20[1]。在AdminCalc-TW上,除了民國年滿分1.00,它的統編檢查碼更拿到0.71,狠甩第二名GLM-5.3-Flash(0.50)達 21 個百分點 [3]。 - 同屬小型商用模型,
GPT-6 Luna在加班費這一項贏過Claude Haiku 5.5超過 60 個百分點(0.921比0.305)。 這兩個模型在特休年資級距對照時幾乎旗鼓相當(0.942比0.895)[1]。但在加班費上,Claude Haiku 5.5平日加班還能對40/60(66.7%;GPT-6 Luna為60/60),一旦進入休息日(5/80)與國定假日(13/50),表現便斷崖式崩潰到僅剩18/130(13.8%);同一組題目,GPT-6 Luna卻穩定拿下115/130(88.5%)[1]。Beam 1.0也呈現完全相同的失血路徑:平日加班60/60滿分,休息日掉到28/80,國定假日只剩10/50[1]。 - 台灣在地語料微調的
TAIDE 12B與Breeze 2 8B,在規則知識與算術上雙雙失守。 台灣語料微調看來沒換到法規計算能力。在LaborCalc-TW上,TAIDE 12B特休僅拿0.258、加班費0.011(2/190,總分0.134);Breeze 2 8B更是只有0.068與0.005(1/190,總分0.037)。就連答案本來就是0的 10 道「未加班」對照題,TAIDE 12B也只答對一半(5/10),Breeze 2 8B更只答對 4 題(4/10)。換句話說,超過一半的零加班情境,兩個模型都硬是算出了加班費 [1]。即便是單一步驟加減1911的民國年換算,除了Flint 1.0(0.82)外其餘所有模型都在0.97至1.00之間,TAIDE 12B卻掉到0.79,Breeze 2 8B只有0.31[3]。 GLM-5.3-Flash特休級距記憶較弱但算術穩健;無工具輔助的自架開源模型碰上明顯上限。GLM-5.3-Flash在特休年資級距題落後Claude Haiku 5.5達 22 個百分點(0.674比0.895),但在加班費計算卻反超逾 20 個百分點(0.511比0.305),也在AdminCalc-TW拿下總分第二(0.750)[1][3]。反觀Qwen3.8-27B與gpt-oss-20b等中型開源模型,雖能在單步民國年換算拿到0.97與0.98,遇到LaborCalc-TW加班費就分別跌到0.147與0.000[1][3]。- 民法第 121 條「月底到職」邊界,讓四大領先模型集體折半。 在 10 道專測「月底到職(像是 1 月 31 日到職)、屆滿當月無相當日」的特休邊界題上,就連
DeepSeek-V4.1-Flash、GPT-6 Luna、Beam 1.0與Claude Haiku 5.5全都只拿到5/10(50%)[1][13]。
四、跨資料集錯誤總帳:38% 套錯規則與 56% 計算崩潰
表 3 與圖 5 彙整了兩套基準測試、共 6,360 筆非對照題評測裡的全部 3,400 筆錯答 [2][4]。
| 評測基準與規則族 | 計分評測數 | 錯答數 | 準確率 | 命中錯誤假設 | 未解釋整數 | 非整數回應 | 未計分 |
|---|---|---|---|---|---|---|---|
| LaborCalc-TW:加班費 | 2,280 | 1,547 | 32.1% | 592 | 769 | 166 | 20 |
| LaborCalc-TW:特休日數 | 2,280 | 1,179 | 48.3% | 284 | 872 | 22 | 1 |
| AdminCalc-TW:統一編號檢查碼 | 900 | 558 | 38.0% | 377 | 178 | 3 | 0 |
| AdminCalc-TW:民國年換算 | 900 | 116 | 87.1% | 43 | 72 | 0 | 1 |
| 合計 | 6,360 | 3,400 | — | 1,296(38%) | 1,891(56%) | 191 | 22 |
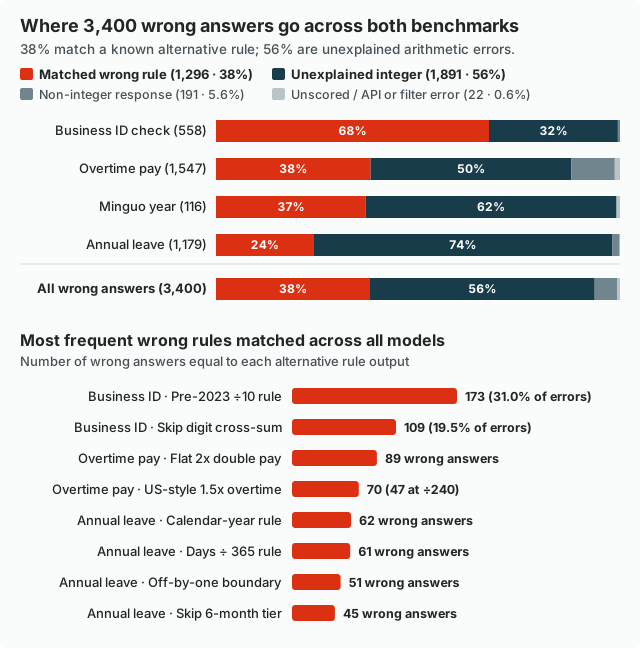
跨兩個資料集加總,未解釋整數錯誤在 LaborCalc-TW 累積 1,641 筆(769 + 872)、在 AdminCalc-TW 累積 250 筆(178 + 72),合計 1,891 筆,佔全部 3,400 筆錯答的 56%;另外 1,296 筆(38%)則精準命中可執行的錯誤規則假設 [2][4]。
結語:語氣流暢,不代表依法合規
把對錯題庫分數換成可執行法規程式與可執行錯誤假設,會直接改寫台灣團隊選用與部署 AI 系統的三個工程判準:
- 台灣語料微調買不到法規執行力,推理紀律才是關鍵。 用大量台灣文本微調小型模型,確實能讓文字讀起來道地自然,但
TAIDE 12B(0.134)與Breeze 2 8B(0.037)在特休年資級距與基本民國年算術上雙雙失守;反而是指令遵循與多步驟推理紀律更強的DeepSeek-V4.1-Flash(0.934與0.855)與GPT-6 Luna(0.932)站上領先位置 [1][3]。 - 確定性的法規算式必須交回給程式碼,不要交給機率預測。 全部錯答中有
56%(1,891/3,400)屬於未解釋的算術或分支失守;就連高性價比的商用模型,只要任務從特休年資級距對照跨進多段倍率加班費計算,準確率就會直接崩掉40到59個百分點 [1][2][4]。凡是由法定算式決定唯一答案的流程,都應該由語言模型負責從自然語言抽取結構化參數,再把最後的算術交給經過驗證的規則引擎執行。 - 用可執行的錯誤假設,直接診斷你的系統正在跑哪一套「世界模型」。 不過證據界線還是要講清楚:模型輸出的數字恰好與某個錯規則吻合,並不能百分之百證明它內部推論的每一步過程 [6];但當整體錯答裡有
38%(1,296筆)對得上具體的錯誤程式,工程團隊就能立刻定位問題是出在過時訓練資料(2023 年前的統編舊規)、硬套進來的美式加班倍數,還是上游雲端 API 的內容審查把「中華民國100年」直接擋在門外 [2][4][5]。
LaborCalc-TW 與 AdminCalc-TW 檢驗的,是當提示詞已經明確點名適用台灣法規時,模型能不能算出對的數字。但在真實的客服、法務與日常對話現場,失靈往往發生在更前一步:台灣使用者只用道地的台灣繁體中文提問,卻沒有特別寫出「在台灣」三個字時,模型預設的適用法域究竟是不是台灣?在擴充 LaborCalc-TW 之餘,我們也正在籌備專測這項隱含前提的**「預設台灣」診斷基準**。
你可以到 LaborCalc-TW 與 AdminCalc-TW 資料集專頁看完整實測結果與規則規格,在互動式法規情境計算器親自測不同出勤與年資組合,或直接上公開程式碼倉庫核對原始題庫、雙重實作與逐題成績(GitHub 上的 laborcalc-tw、Hugging Face 上的 LaborCalc-TW、GitHub 上的 admincalc-tw、Hugging Face 上的 AdminCalc-TW)。
資料來源
- [1]
laborcalc-tw: index/2026Q4/index.json - [2]
laborcalc-tw: eval/scores/2026Q4/items.jsonl - [3]
admincalc-tw: index/admincalc-2026Q4/site-data/results.json - [4]
admincalc-tw: eval/scores/admincalc-2026Q4/items.jsonl - [5]
admincalc-tw: silver/families/ban_checksum/spec.yaml - [6]
admincalc-tw: README - [7]
laborcalc-tw: figures/scores.svg - [8]
laborcalc-tw: gold/releases/<release>/public/*.manifest.json;admincalc-tw: gold/releases/<release>/public/*.manifest.json - [9]
laborcalc-tw: figures/pipeline.svg;laborcalc-tw: figures/scores.svg;admincalc-tw: figures/pipeline.svg;admincalc-tw: figures/scores.svg - [10] 《勞動基準法》第 24 條(平日與休息日延長工時加給
4/3、5/3倍率);第 39 條(休假日出勤加倍發給);行政院勞工委員會 90 年 6 月 26 日台 90 勞動 2 字第 0026202 號函(月薪制平日每小時工資額以月薪除以240推算);勞動部〈加班費示意圖〉(休息日第 9–12 小時按8/3倍計給)與加班費試算系統 - [11] 美國《公平勞動基準法》(Fair Labor Standards Act, 29 U.S.C. § 207(a)(1):逾每週 40 小時按不低於正常工資率
1.5倍計給)(美國政府出版局 GovInfo 法典文本);美國勞工部(U.S. Department of Labor)加班費規定 - [12] 《勞動基準法》第 38 條第 1 項(特別休假年資級距:滿 6 個月以上 1 年未滿者 3 日,及 7/10/14/15/上限 30 日);《勞動基準法施行細則》第 5 條第 1 項(年資自受僱當日起算)與第 24 條第 2 項(週年制、曆年制等行使期間規定)
- [13] 《民法》第 121 條(以月或年定期間,於最後之月無相當日者,以其月之末日為期間末日);勞動部特別休假日數試算系統
- [14] 財政部財政資訊中心〈營利事業統一編號檢查碼邏輯修正說明〉(2021-12-22 發布,除數由
10改為5,2023-03-31 前完成修改)(修正說明附件 PDF) - [15] 內政部戶政司〈年歲對照表〉(民國紀年與西元年對照)
- [16]
hsiaoa/ai-taiwan-sovereignty-benchmark(Taiwan Sovereignty Benchmark,2025 年 8 月)

